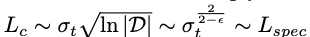能動的推論(active inference)

こちらの本を読んだのでメモ

認知機能を持つ主体の認識の仕組みを統一的な観点で説明する理論として自由エネルギー原理というものがあり、その枠組を行動の推論にまで広げたのがactive inference。この本の著者の一人であるKarl Fristonが自由エネルギー原理の提唱元の人物。

本の内容としては 2部に大わけしてあり、 前半がframeworkの内容や理論についての解説、 後半が実際に問題に応用する際に必要な設計方法や具体例の紹介という形。

1部

  • 個別事象のベイズ推定から始めて自由エネルギー原理の考え方にたどりつく方向で解説
  • 生物は生存するために適切な状態を維持する必要がある、という前提から始めて自由エネルギー原理の考え方にたどりつく方向で解説
  • 変分推論との関連や生成モデルの具体的な形について解説
  • 既知の脳の仕組みとの合致など生物学的な意味について解説

全体像を知りたい場合は2章、3章を読むので十分把握できると思われる。

2部

  • active inferenceを用いるとき必要な生成モデルや生成プロセスの各要素の設計や種類
  • 離散・連続モデル、階層型のモデルなどについて
  • toy problemにおける具体的なモデル、計算例の紹介
  • 対象の生成モデルを分析する科学者のモデルへの応用例

最後の10章は全体のまとめのような形で、このframeworkと他の分野や理論との関わりについてまとめている。

重要な概念まとめ

自由エネルギー原理とactive inference

  • 自由エネルギー原理は、予測誤差を最小限にするよう自身の認識を更新していくというもの
    • 脳は感覚情報を元に状態を予測するという生成モデルという言い方
  • 近い理論としてベイズ脳仮説や予測符号化

active infereneceはこの枠組みに行動推論も含めたものという立ち位置で

  • 自身が望む状態へ到達するには認識を変化させるだけでは不可能なケースがある
  • 環境側を変化させるために外部に働きかける(=行動する)必要がある
  • 将来の期待される自由エネルギーを最小化する行動系列を推論することでその行動を決める
    • = active inference

変分自由エネルギー

F = D_KL[Q(x) || P(x|y)] - ln P(y)
 where x: 隠れ状態
       y: 観測
       Q(x): 近似事後分布(自身のもつ環境の状態を予測する分布)
       P(x|y): 環境の真の事後分布
  • 第1項がが自分の予測と環境の真の分布とのKL divergence(=距離のようなもの)
  • 第2項が観測の対数確率(驚き)

前者のQを最適化することが認識の更新であり、その時点での観測に対し、隠れ状態の分布をあわせるよう更新する。 yは観測であり、これは自身の内部の生成モデルの更新では変化させられない。 ここを最小化するには観測yを変化させるために環境に働きかける必要があり、適切な働きかけ方を決めるために期待自由エネルギーを用いる。

この式は数式の変形によって様々な意味を表す項として置き換えることが可能。

期待自由エネルギー

G = -E_Q(x,y|pai)[ D_KL[Q(x,y|pai) || Q(x|pai)]] - E_Q(y|pai)[ln P(y|C)]
  where x: 未来の予測した隠れ状態の系列
        y: 未来の予測した観測の系列
        pai: 採った行動系列(policy)
        E_Q: 分布Qによる期待値
  • 第1項が観測を得る前後の認識の変化の大きさ(情報利得)
  • 第2項が予測される結果の望ましさの度合い(実利的価値)

将来の行動を反実仮想で考えるためにpolicyに条件づけされた自由エネルギーとなっており、これを最小にするpolicyが採るべきものとなる (未来の行動をとった際に予測される結果と認識との誤差を累積したもの)

こちらも変分自由エネルギーと同様、数式の変形によって様々な意味を表す項として置き換えることが可能。

マルコフ・ブランケット

agent(内部状態)と環境(外部状態)は直接的に相互作用しているわけではなく、活動状態と感覚状態を経由して間接的に影響を与えている。

  • agentは行動することによって環境に働きかけてそれによって環境を変化させることができる
    • agent -> 環境の間にあたるものが活動状態
  • agentは環境の変化を自身の感覚器官でキャッチし、それを感覚情報として認識することによって環境からの影響を受ける
    • 環境 -> agentの間にあたるものが感覚状態

数学的には条件付き独立であることを指している

p(u,x|b) = p(u|b) * p(x|b)

であるときbはブランケットであり、bを既に知っているときに後からxを知ったとしてもuについての追加情報は得られない、ということを意味する。

これが重要なのは、ブランケットによる間接的な影響の形をとっているからこそ、agentは自身を環境から独立したものとして保つことができるという点。仮にブランケットのない状態を考えるとagentは環境の変化の影響をそのまま受けてしまい、生物の持つ生存条件を保つなどの基本的な要求が満たせないことになる。

この本以外の文献

本で参考文献として書かれているものや出てくるワードなどに関連したメモ

rustでMCTSの手動実装

ここ1~2年のLLMの性能向上により実装そのものはほとんどしなくて済むようになった。 outputを作るという意味ではそれでよいのだが、仕組みの勉強や楽しみとして手動実装。

やったこと

  • MCTSの仕組みを実装で理解
    • rust自体も不慣れなので勉強しつつ
  • LLMは調査・部分的なデバッグ用に利用しコードそのものは書かせない

MCTSについて

Monte Carlo(MC) methodをtree searchに応用したものなのでMonte Carlo Tree Search(MCTS)

MCはランダムに実行した結果によって近似解を得る手法のこと。有名なのは例えばこれとか

  • 正方形の中にランダムに点をうち
  • 半径1の円の中に入った点の数の割合で円周率を割り出す

MCTSは

  • 木構造の形を利用し、価値の高そうな対象に絞ってMCを行うことで効率的に解を探索する手法のこと
  • 状態を木構造のnodeとして扱って進捗に合わせて展開しつつ、そのnodeからMCでプレイすることで近似的に最適な遷移を得てそれをnodeの価値として更新していく

全体を網羅的に探索するのは大きすぎて不可能でも、最適に近そうな解を辿って探索していくことで計算量を抑えつつ良い解を探す形。

基本的な流れはこちら

  • select
    • 現状で有望な状態(node)を探す
  • expand
    • nodeに新しいchildを足す
  • rollout
    • 足したchildからプレイ開始
  • update
    • プレイ結果に応じて通ったnodeの価値や訪問回数を更新

nodeの選び方には様々な方法があるようだが、今回は基本として有名なUCTを利用する。 勝率などの外的な報酬値に加え、訪問回数が多いnodeは探索対象に選ばれにくくなるようpenaltyを与えた上でnodeの価値を算出するもの。

こちらでわかりやすく解説してくれている
https://qiita.com/pocokhc/items/392a7f89c79f5e1e6bca#uctucb-applied-to-trees

実装

題材は迷路でのゴールへの到達 (2d gridの実装は別の目的で使っていたものがあるのでそれを流用)

デバッグしやすいように外壁含めて5x6のとても小さいもの
https://github.com/y-kamiya/machine-learning-samples/pull/36/changes#diff-ba7cba466f7b3a2e6bbde7c4781f15fda873836e62375905eecf42863948b628

MCTSに関する部分の形

  • grid上での位置をnodeのstate、移動をactionとして扱う
  • 壁に向かう方向への移動はinvalidなものとして選択肢に含めない
    • 含めてもよいが単純にnode数が増えて煩雑になるだけであるためデバッグしやすさを考慮して排除
  • 学習段階におけるnodeの選択と生成
    • UCTのスコアが高いものをrootからたどる
    • 選択可能actionの中でnode未生成のものがあればその中からrandom選んでnode生成
  • 外的な報酬はゴールに到達した場合に1のみ
  • rolloutは選択可能actionからrandomで上限数まで移動するだけ

UCTのスコア付け
https://github.com/y-kamiya/machine-learning-samples/pull/36/changes#diff-36e5761bdbbc83642f8f129fa69eb42cd77d3eac962f1a75b3bacdb7a60f45ceR68-R81

設定上の注意点として、1 rolloutあたりでのaction数は迷路が小さいのでその分小さくする必要がある
https://github.com/y-kamiya/machine-learning-samples/pull/36/changes#diff-36e5761bdbbc83642f8f129fa69eb42cd77d3eac962f1a75b3bacdb7a60f45ceR267

最後に追加でgoalまでのstep数によるpenaltyを入れたので、それがあれば大きな値でも早めに収束するが、単純にgoal到達で1のみのrewardの形の場合にはこれを大きくすると収束しづらくなる。

これは迷路が小さいためにaction数が大きいとどのnodeからでもgoalに到達するケースが増えてしまい、node毎のscoreの差がつきづらくなる結果、有望なnode(=goalに近いnode)から探索するというアルゴリズムのメリットが活かせなくなるため。

MCTS以外についてのメモ
  • nodeの参照や更新の際、nodeそのものを借用して受け渡すと変数のライフタイムの制約に引っかかる
    • indexのみ受け渡す形にして参照は関数内で区切る形で実装する

これは明確にrustのよい部分でcompilerが検出してくれるため不正な参照が生じずに済むのはありがたい。

このレイヤーでの注意点は実務上ではLLMにcodingさせてcompilerで明確にチェックすることで人手に依らず安全に素早く書けるため、強めに静的な検証が入るのはとても実用的に感じる。

実装時のLLMの活用(勉強のための)について良し悪し

良い点
  • 本筋のやりたいこと以外部分の調査などに時間を使わず済む
    • やりたいことに対して一般的な構成方法(現状のbest practice)として一定以上の適した形をすぐに提案・解説してくれる
    • LLMなしの場合、ここでweb上の調査をしていろいろな変遷や事情を理解するため時間がかかっていた
      • rustそのものに不慣れであるため、一般的な構成方法を調べるなど
  • 時間を決めてLLMデバッグ
    • 初めて見るcompile errorや複雑なものは、一定以上の時間考えてわからない場合はLLMで意味を解説させて把握
    • ハマって抜け出せなくなり進まない、挫折するということは避けられる
悪い点
  • おそらく時間をかけて調査をすることで得られたであろう周辺知識が入らない
    • そのときまさに問題となっている件を解決するために必要な周辺知識のinputが薄くなる
    • 目的達成という意味では問題ないが、勉強という意味だとそのケース以外の情報を得る、得ざるを得ないという状況は良い機会となっていたとも言える
  • デバッグなどの検証作業において得ていた意味の理解が浅くなる
    • LLMで問題解決・解説させて把握するのと、意味を理解するために試行錯誤しつつ考えて全体を把握してから解決する、のでは理解の程度が全く異なる
      • どの部分でどの程度の理解が必要なもの(勉強の目的)なのかは意識して区分けつつ取り組む必要
    • 経験上、応用や実践で役立つのは後者で得たものなため

diffusionにおける汎化の境界

以下の論文について勉強したことのメモ
An exact information theory of generalization phase transitions in Bayesian diffusion models
paper: https://arxiv.org/abs/2607.08041

  • diffusionの学習においてデータの暗記と汎化の境界を、学習データ数とdenoise時に得られる情報量との関係で示した
    • 汎化に必要なデータ数が画像の素の次元数の指数オーダーには依らず、大きく緩和された基準に
  • 自然画像においては以下の2つが両立可能な状態を保つため次元の呪いを回避して学習できる
    • modelが汎化の状態を保つのに必要な参照領域のサイズの上限
    • 効率的にdenoiseを学習するために参照することが必要な領域のサイズの下限

BIRD modelについて

論文中で扱っているbayesian information restricted diffusion(BIRD) modelとは bayes optimal modelに対してinput情報を制限したもののこと

情報の制限の方法として、image上の位置xの周辺pixel領域Cのみを見ることができる形を想定(=spatially local BIRD models)

We introduce an intuitively appealing general concept of BIRD models in which each image pixel x can be thought of as an agent which observes at time t in the reverse generation process restricted information Cx,t about a noisy image φt

bayes optimal modelとは

  • 理想的な形でbayes推論(得た観測結果を元に事後確率を予測していく)を行うモデル
    • input全体を元に推論し、model capacityも十分で学習も理想的な形で終えているという理想ケース
  • この場合、有限のdatasetに対しては必ず事後分布が1点に収束(=必ず暗記するので汎化しない)

While the Bayes optimal diffusion model is appealing in terms of both its analytic and conceptual simplicity, it unfortunately always memorizes the training data by eventually flowing to one of the training points φ ∈ D

既存のunetやDiTを用いた画像生成向けdiffusion modelは

  • bayes optimal modelを目標として学習しているが
  • model architectureや学習方法などにより情報が制限されている状態であり
  • 経験的に確かに汎化している(訓練データ以外の画像を自然に見える形で生成できる)

式2がbayes optimal modelでの、式3がBIRDでのdnoiseによる事後分布の期待値推定方法であり、 2は画像全体、3は領域Cのみを条件づけとして与える形になっているところだけが差分

以下を比較し関係係数が0.9程度と高い一致度を示した、というのが実験結果

  • 既存モデルの学習における10~30 epoch付近での出力画像
  • BIRD modelによる出力画像

暗記と汎化の境界

generalizationとmemorizationの境界については式4で、以下の2つが等しいとき

  • ln|D|: 学習データ数の対数
  • I(φ; Cx,t): denoise時に参照可能なnoised dataの参照可能領域Cとtest data φ の相互情報量

Iについて

I(Cx,t; φ) is the mutual information between a test data point φ drawn from the true data distribution P0(φ) and the pixel observation Cx,t under the forward testing Markov chain φ → φt → Cx,t

あるtest dataをforward processでnoise付与し、その一部領域を切り取ったものがCであり、 これと元のclean imageの相互情報量のこと

the average of the Bayesian surprise DKL(Ptest(φ|Cx,t)||P0(φ)) over the marginal distribution Ptest(Cx,t) yields the mutual information I(φ; Cx,t)

あるCによってどの程度情報が絞り込めたか、はbayes surpriseと呼ばれ、以下のKLDivで表される

  • given Cのときの事後信念
  • 事前の信念prior P0(\phi)

Cにおけるnoise付与のパターンは無数にあり、それらをforward processにおけるCの発生確率(周辺確率P_test(C,x)) で重み付き和を取ったものがIとなる

Iを算出した方法としては2通り(fig.3に関して)

  • gaussian upper boundによって上から抑えた値(real dataset向け)
  • 事後entropy S[P_train]を算出(toy dataset向け)
    • そして汎化相の場合はlog|D| - S = I という関係からIがわかる

前者は情報理論の性質としてわかっている以下を用いたもの

  • ある共分散行列を持った分布の中で、最もentropyが大きいのはgaussianである

なのでdatasetのimageの領域Cに対して共分散行列を(各noise levelで)算出すると理論的な上限値のラインが描ける(fig.3の一部) 詳細はappendix E.2

なぜ次元の呪いを回避できているのか

diffusionによる学習を効果的に進めるためには、各pixelのdenoiseのためにその周囲の一定以上のサイズの領域をmodelが観測できる必要がある(周囲との関係によって初めてそのpixelを何にすべきかが決まるので)

fig.4aが上記についての簡易な実験の結果で、Lがpixel周囲の観測可能部分の辺の長さ

  • 領域が小さいとき(L=5)はtrain/test imageのどちらもぼけ気味
  • 領域が大きいとき(L=33)はtrainは鮮明だがtest imageは崩壊気味
  • ちょうどよいのがL=7程度

つまり効果的にdenoise方法を学習するにはLは一定以上大きい必要があるが、大きすぎれば暗記と汎化の境界を超えて暗記相に入ってしまい、test imageが崩壊する。なのでちょうどよいLの値にしておく必要がある。

自然画像の場合、このちょうどよいLというのがどのtimestepでもちゃんと存在している状態を保っている、というのがfig.4bの図。

各noise level(=timestep)における

  • 暗記と汎化のLの境界(numerical: Lc)
  • 効果的に学習するためのLの境界(spectral: Lspec)

であり、noise levelに応じてspectral < numericalの関係を保ったままどちらも単調増加している。

5.2に書いてあるようにLc, Lspecの両者が等しいとした場合、dataset sizeの対数(ln|D|)がスペクトルスケール(Lspec)に比例する、という関係が出てくる

このLspecが最も大きくなる場合(=画像全体)が、dataset sizeが最も大きい必要がある場合(汎化相に居続けるために)であり、その関係を示したのが式8。epsilonは5.2本文に書いてあるように自然画像だと0.1~0.3程度の値でありとても小さい。

なので、学習する画像の辺の長さが大きくなると、そのeplison乗に応じた指数関数に比例する形でdataset sizeを大きくする必要がある、という関係。

これは元々考えられていた関係である、画像のpixel数の指数関数というオーダーに比べてはるかに緩和されたものになっている。