以下の論文について勉強したことのメモ
An exact information theory of generalization phase transitions in Bayesian diffusion models
paper: https://arxiv.org/abs/2607.08041
- diffusionの学習においてデータの暗記と汎化の境界を、学習データ数とdenoise時に得られる情報量との関係で示した
- 汎化に必要なデータ数が画像の素の次元数の指数オーダーには依らず、大きく緩和された基準に
- 自然画像においては以下の2つが両立可能な状態を保つため次元の呪いを回避して学習できる
- modelが汎化の状態を保つのに必要な参照領域のサイズの上限
- 効率的にdenoiseを学習するために参照することが必要な領域のサイズの下限
BIRD modelについて
論文中で扱っているbayesian information restricted diffusion(BIRD) modelとは bayes optimal modelに対してinput情報を制限したもののこと
情報の制限の方法として、image上の位置xの周辺pixel領域Cのみを見ることができる形を想定(=spatially local BIRD models)
We introduce an intuitively appealing general concept of BIRD models in which each image pixel x can be thought of as an agent which observes at time t in the reverse generation process restricted information Cx,t about a noisy image φt
bayes optimal modelとは
- 理想的な形でbayes推論(得た観測結果を元に事後確率を予測していく)を行うモデル
- input全体を元に推論し、model capacityも十分で学習も理想的な形で終えているという理想ケース
- この場合、有限のdatasetに対しては必ず事後分布が1点に収束(=必ず暗記するので汎化しない)
While the Bayes optimal diffusion model is appealing in terms of both its analytic and conceptual simplicity, it unfortunately always memorizes the training data by eventually flowing to one of the training points φ ∈ D
既存のunetやDiTを用いた画像生成向けdiffusion modelは
- bayes optimal modelを目標として学習しているが
- model architectureや学習方法などにより情報が制限されている状態であり
- 経験的に確かに汎化している(訓練データ以外の画像を自然に見える形で生成できる)
式2がbayes optimal modelでの、式3がBIRDでのdnoiseによる事後分布の期待値推定方法であり、 2は画像全体、3は領域Cのみを条件づけとして与える形になっているところだけが差分
以下を比較し関係係数が0.9程度と高い一致度を示した、というのが実験結果
- 既存モデルの学習における10~30 epoch付近での出力画像
- BIRD modelによる出力画像
暗記と汎化の境界
generalizationとmemorizationの境界については式4で、以下の2つが等しいとき
- ln|D|: 学習データ数の対数
- I(φ; Cx,t): denoise時に参照可能なnoised dataの参照可能領域Cとtest data φ の相互情報量
Iについて
I(Cx,t; φ) is the mutual information between a test data point φ drawn from the true data distribution P0(φ) and the pixel observation Cx,t under the forward testing Markov chain φ → φt → Cx,t
あるtest dataをforward processでnoise付与し、その一部領域を切り取ったものがCであり、 これと元のclean imageの相互情報量のこと
the average of the Bayesian surprise DKL(Ptest(φ|Cx,t)||P0(φ)) over the marginal distribution Ptest(Cx,t) yields the mutual information I(φ; Cx,t)
あるCによってどの程度情報が絞り込めたか、はbayes surpriseと呼ばれ、以下のKLDivで表される
- given Cのときの事後信念
- 事前の信念prior P0(\phi)
Cにおけるnoise付与のパターンは無数にあり、それらをforward processにおけるCの発生確率(周辺確率P_test(C,x)) で重み付き和を取ったものがIとなる
Iを算出した方法としては2通り(fig.3に関して)
- gaussian upper boundによって上から抑えた値(real dataset向け)
- 事後entropy S[P_train]を算出(toy dataset向け)
- そして汎化相の場合はlog|D| - S = I という関係からIがわかる
前者は情報理論の性質としてわかっている以下を用いたもの
- ある共分散行列を持った分布の中で、最もentropyが大きいのはgaussianである
なのでdatasetのimageの領域Cに対して共分散行列を(各noise levelで)算出すると理論的な上限値のラインが描ける(fig.3の一部) 詳細はappendix E.2
なぜ次元の呪いを回避できているのか
diffusionによる学習を効果的に進めるためには、各pixelのdenoiseのためにその周囲の一定以上のサイズの領域をmodelが観測できる必要がある(周囲との関係によって初めてそのpixelを何にすべきかが決まるので)
fig.4aが上記についての簡易な実験の結果で、Lがpixel周囲の観測可能部分の辺の長さ
- 領域が小さいとき(L=5)はtrain/test imageのどちらもぼけ気味
- 領域が大きいとき(L=33)はtrainは鮮明だがtest imageは崩壊気味
- ちょうどよいのがL=7程度
つまり効果的にdenoise方法を学習するにはLは一定以上大きい必要があるが、大きすぎれば暗記と汎化の境界を超えて暗記相に入ってしまい、test imageが崩壊する。なのでちょうどよいLの値にしておく必要がある。
自然画像の場合、このちょうどよいLというのがどのtimestepでもちゃんと存在している状態を保っている、というのがfig.4bの図。
各noise level(=timestep)における
- 暗記と汎化のLの境界(numerical: Lc)
- 効果的に学習するためのLの境界(spectral: Lspec)
であり、noise levelに応じてspectral < numericalの関係を保ったままどちらも単調増加している。
5.2に書いてあるようにLc, Lspecの両者が等しいとした場合、dataset sizeの対数(ln|D|)がスペクトルスケール(Lspec)に比例する、という関係が出てくる
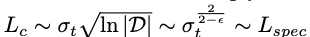
このLspecが最も大きくなる場合(=画像全体)が、dataset sizeが最も大きい必要がある場合(汎化相に居続けるために)であり、その関係を示したのが式8。epsilonは5.2本文に書いてあるように自然画像だと0.1~0.3程度の値でありとても小さい。
なので、学習する画像の辺の長さが大きくなると、そのeplison乗に応じた指数関数に比例する形でdataset sizeを大きくする必要がある、という関係。
これは元々考えられていた関係である、画像のpixel数の指数関数というオーダーに比べてはるかに緩和されたものになっている。
